Introduzione
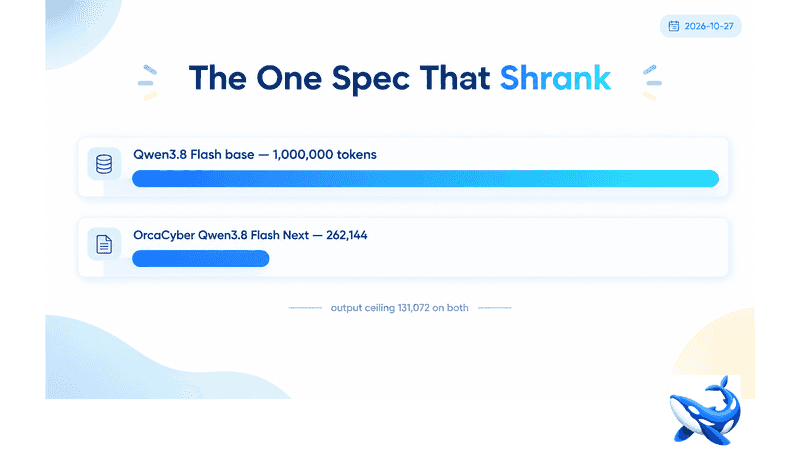
Grazie a OrcaRouter, il modello base e la versione ottimizzata sono affiancati su un unico tasto, e il confronto è insolitamente netto. La scheda Qwen3.8 Flash Next — la versione ottimizzata da OrcaCyber basata sul Qwen3.8 Flash Next di Alibaba, rilasciata il 26 ottobre 2026 — contiene 262.144 token di contesto, contro il milione [ OURS] del modello di base. Si tratta del 26,2%, poco più di un quarto. Tutte le altre caratteristiche del modello rimangono invariate: il limite massimo di output è 131.072 in entrambi i casi, mentre le modalità sono testo, immagine e video in entrambi.
Il contesto è la specifica che si è ridotta, ed è proprio quella che modifica le potenzialità di un flusso di lavoro.
I numeri, a confronto
| Qwen3.8 Flash (base) | OrcaCyber Qwen3.8 Flash Next | |
| Finestra di contesto | 1.000.000 | 262.144 |
| Limite massimo di output | 131.072 | 131.072 |
| Modalità di inserimento | testo, immagine, video | testo, immagine, video |
| Input / M | 0,15 $ | 0,80 |
| Uscita / M | 0,47 $ | 1,60 $ |
| Lettura cache / M | 0,0184 | 0,15 |
| Scrittura nella cache / M | 0,23 | — |
| Pubblicato | 26/08/2026 | 26/10/2026 |
Tre aspetti saltano all’occhio. Il limite massimo di output è rimasto invariato, il che significa che un artefatto di grandi dimensioni rientra ancora in una singola risposta. Le modalità sono rimaste invariate, il che significa che il percorso di elaborazione visiva è sopravvissuto alla messa a punto. E il costo di input è aumentato di 5,33 volte mentre la finestra si è ridotta di un fattore 3,8: si paga di più per token per uno spazio inferiore.
Cosa contiene effettivamente 262.144 token
Un quarto di milione di token non è una cifra da poco. Corrisponde all’incirca a 200.000 parole, a un libro di 400 pagine o al codice sorgente di un repository di medie dimensioni con i manifest allegati.
Ciò che non contiene è l’intero monorepo di grandi dimensioni più i relativi log e la cronologia dei ticket. È proprio in questa combinazione che una finestra da un milione di token giustifica il proprio prezzo, ed è esattamente la combinazione che questa scheda non è in grado di gestire.
La conseguenza pratica è una decisione di progettazione che devi prendere prima di procedere: una chiamata o due. Nel modello di base, un audit di grandi dimensioni corrisponde a una sola richiesta. Con questa scheda, lo stesso materiale diventa due richieste — suddivise in base a un confine naturale, con i risultati della prima metà riportati nella seconda chiamata come contesto.
La suddivisione ha un costo. Si paga due volte la velocità di output per ogni fase di sintesi, si perde il ragionamento trasversale e si crea uno spazio in cui gli errori possono accumularsi. Per un repository in cui la vulnerabilità risiede in un unico pacchetto, nulla di tutto ciò ha importanza. Per uno in cui il bug è una discrepanza tra il servizio A e il servizio C, invece, è rilevante.
Perché una finestra di un quarto potrebbe comunque essere la scelta giusta
C’è una ragione difendibile per cui la build viene distribuita a 262.144 anziché a un milione, e non si tratta di pigrizia: fornire un contesto lungo è costoso. L’elaborazione di oltre un milione di token comporta un costo in termini di memoria e tempo per ogni richiesta, e una build ottimizzata presenta già un delta di ottimizzazione oltre ai pesi di base. Ridurre la finestra a un quarto mantiene la scheda utilizzabile con un input di 0,80 $, anziché a una tariffa che farebbe sembrare esiguo il premio per l’assenza di rifiuti.
La piattaforma all-in-one per un SEO efficace
Dietro ogni azienda di successo c'è una forte campagna SEO. Ma con innumerevoli strumenti e tecniche di ottimizzazione tra cui scegliere, può essere difficile sapere da dove iniziare. Ebbene, non temete più, perché ho quello che fa per voi. Vi presento la piattaforma Ranktracker all-in-one per una SEO efficace.
Abbiamo finalmente aperto la registrazione a Ranktracker in modo assolutamente gratuito!
Creare un account gratuitoOppure accedi con le tue credenziali
Se questo compromesso fa al caso vostro dipende dalla distribuzione dei vostri input. Se la maggior parte delle vostre richieste è inferiore a 100.000 token — un singolo file, una traccia dello stack, uno screenshot più un documento — la finestra non si blocca mai e la scheda è semplicemente un modello abliterato più economico da servire. Se le tue richieste superano regolarmente i 200.000, il modello base o una variante con finestra da 1 milione è la scelta corretta e la differenza di prezzo è irrilevante.
Cosa richiede il gate e perché ci vuole una settimana
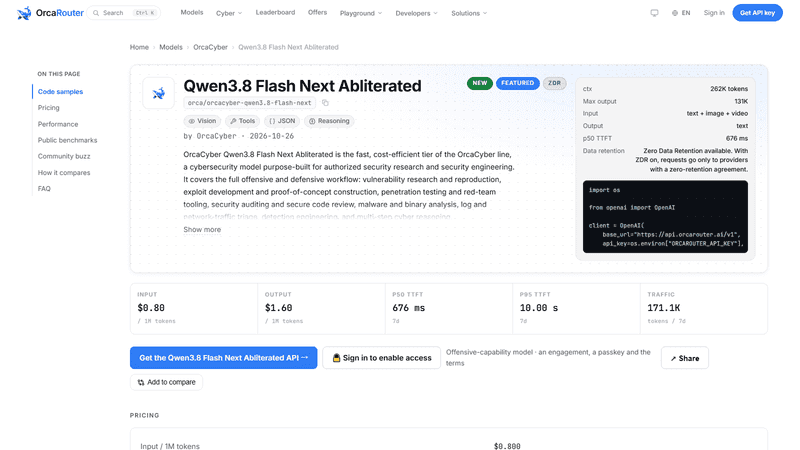
L’accesso a ogni scheda OrcaCyber passa attraverso una procedura di attivazione, una chiave di accesso e l’accettazione dei termini prima che l’endpoint elabori una richiesta [OURS]. Nel caso di una scheda che state valutando anziché distribuendo, è facile rimandare questa sequenza — e proprio il rimandarla è il motivo più comune per cui un passaggio va a monte.
Consideratela come la prima attività da svolgere, piuttosto che l’ultima. Le pratiche burocratiche procedono in parallelo con la valutazione tecnica, e le due rispondono a domande diverse: se volete la scheda e se potete averla.
C’è una conseguenza che vale la pena pianificare. Una passkey è un segreto operativo che finisce nella vostra configurazione di distribuzione, il che significa che viene sottoposta a qualunque processo di rotazione dei segreti abbiate in atto. Se quel processo richiede due settimane, quello è il vero tempo di consegna, non quello indicato nel modello.
Cosa cambia nella finestra trimestrale per quanto riguarda i test
Se si confronta questa scheda con il modello di base, la finestra modifica sia la progettazione dei test che il carico di lavoro.
Un caso di test che invia 400.000 token non può essere eseguito affatto su questa scheda, quindi l’insieme di confronto deve essere ricavato da materiale adatto a entrambe. Va bene così — è lo stesso insieme che usereste in produzione — ma significa che la valutazione non può dirvi come la scheda gestisce gli input che non può accettare.
Per quelle, l’unica domanda utile riguarda l’instradamento: quale percentuale di traffico arriva lì e cosa ne viene di esso. Una regola di instradamento che invii le richieste sovradimensionate al modello base deve esistere prima che la prima richiesta fallisca, non dopo.
Cosa la pagina non vi dice ancora
Al momento della stesura di questo articolo, la scheda è in funzione da un giorno e la sua telemetria lo dimostra: 1.345 token l’hanno attraversata nella settimana misurata [LA NOSTRA]. Si tratta di una manciata di richieste. Il blocco relativo alla latenza sulla pagina riporta un p50 di 500 ms e un tasso di errore del 75% — entrambi calcolati su quella stessa manciata di richieste, e nessuno dei due rappresenta un’affermazione sul modello.
La piattaforma all-in-one per un SEO efficace
Dietro ogni azienda di successo c'è una forte campagna SEO. Ma con innumerevoli strumenti e tecniche di ottimizzazione tra cui scegliere, può essere difficile sapere da dove iniziare. Ebbene, non temete più, perché ho quello che fa per voi. Vi presento la piattaforma Ranktracker all-in-one per una SEO efficace.
Abbiamo finalmente aperto la registrazione a Ranktracker in modo assolutamente gratuito!
Creare un account gratuitoOppure accedi con le tue credenziali
Quindi questa è una scheda che dovete valutare in base alle specifiche e ai vostri test, non alle prove in produzione. Le specifiche sono abbastanza chiare: una finestra di un quarto, un limite massimo di output completo, tre modalità di input, un multiplo di input di 5,33× e una messa a punto che elimina i rifiuti.
La piattaforma all-in-one per un SEO efficace
Dietro ogni azienda di successo c'è una forte campagna SEO. Ma con innumerevoli strumenti e tecniche di ottimizzazione tra cui scegliere, può essere difficile sapere da dove iniziare. Ebbene, non temete più, perché ho quello che fa per voi. Vi presento la piattaforma Ranktracker all-in-one per una SEO efficace.
Abbiamo finalmente aperto la registrazione a Ranktracker in modo assolutamente gratuito!
Creare un account gratuitoOppure accedi con le tue credenziali
Il test decisivo richiede un pomeriggio. Prendete dieci richieste che inviate già al modello di base, riproducetele su questa scheda e registrate due cose: se qualcuna di esse ha richiesto più di 262.144 token e se qualcuna è stata rifiutata dal modello di base. Se la prima risposta è no e la seconda è spesso, la scheda è adatta. Se la prima risposta è sì, nessuna regolazione potrà compensare.
Conclusione
Il Qwen3.8 Flash Next "abilitato" mantiene il limite massimo di output e le modalità, moltiplica il prezzo per 5,33 volte in termini di input e restituisce tre quarti della finestra di contesto. Quest’ultimo dato è determinante.
Se i vostri input rientrano nei 262.144 token, la scheda fa ciò che promette. In caso contrario, il modello di base a un quinto della velocità di input rappresenta l’acquisto migliore, e nessuna regolazione modifica questa equazione.
Nota sulle fonti: prezzi, finestre di contesto, limiti massimi e modalità provengono dal catalogo OrcaRouter, verificato il 27/10/2026 [OURS]. Il volume settimanale di 1.345 token è tratto dalla telemetria di produzione di OrcaRouter relativa ai sette giorni terminati il 26 ottobre 2026 ed è troppo esiguo per avvalorare qualsiasi affermazione in merito a latenza o affidabilità — nessuna delle quali viene qui avanzata [OURS]. Le righe relative ai benchmark non vengono utilizzate in questo articolo.

