
はじめに
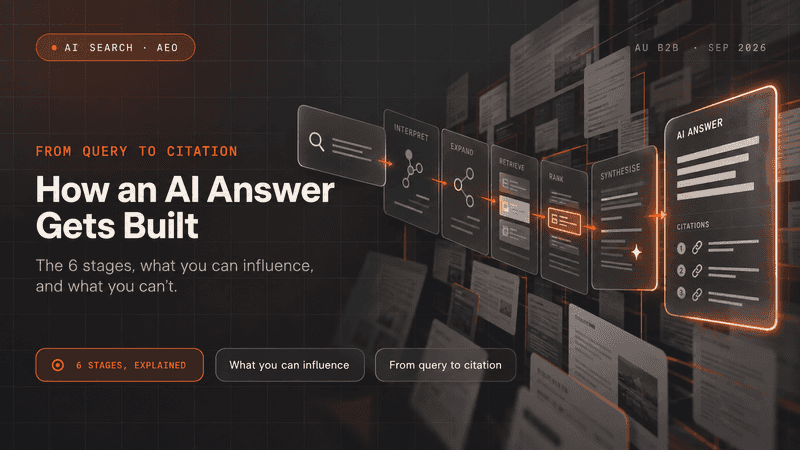
AIによる回答は6つのステップを経て生成されます。システムは質問を読み取り、それをより小さな検索単位に分割し、情報源を見つけ、最適な証拠を選び出し、回答を作成し、出典を追加します。Googleが2026年5月に発表したAI検索に関するガイドでは、これらのステップのうち「検索結果の抽出」と「クエリのファンアウト」の2つが挙げられています。マーケターは、自社のコンテンツが検索されやすく、関連性が高く、裏付けが容易になるよう調整することはできますが、モデルの選択を操作したり、出典の記載を強制したりすることはできません。
主な事実
- AIによる引用は結果に過ぎません。どのパブリッシャーも、それを意図的に有効にすることはできません。
- 引用に先立って検索による発見が必要です。ページが評価され、有用であると判断されて初めて、その功績が認められるのです。
- 一部の段階では影響を与える余地があります。クロールへのアクセス、関連性、根拠、明瞭さは、部分的に企業の手に委ねられています。
- その他の段階はモデルに委ねられています。クエリの解析、内部スコアリング、生成された回答、そして最終的な引用先は、すべてシステムが決定します。
- アンサーエンジン最適化(AEO)は、診断として最も効果を発揮します。修正に費用をかける前に、可視性が損なわれている段階を特定してください。
質問から引用に至る6段階のプロセス
AIエンジンが回答を構築し、出典を引用する仕組みを理解するには、まず、プロセスのどの部分にマーケターが影響を与えられ、どの部分が制御の及ばない範囲にあるかを把握することから始めます。以下の6つの段階は、すべてのAI製品が同一のアーキテクチャを採用していることを示唆するものではなく、実用的な作業モデルを提供するものです。
Googleは2026年5月15日、AI検索に関する初の公式ガイドを公開した。Search Centralでの発表によると、検索エンジン最適化(SEO)のベストプラクティスが引き続き基盤となる。他のプラットフォームは、独自の検索、ランキング、生成システムを運用している。
大まかに言えば、その流れは次のようになります:
| 段階 | 何が起こるか |
| 1. クエリの解釈 | システムは、ユーザーが何を尋ねているのかを解析します。 |
| 2. サブクエリの展開 | 質問は、関連する検索や情報ニーズに分解されます。 |
| 3. 検索 | システムは、関連性のある可能性のある情報源を見つけ出します。 |
| 4. 文章のランク付け | 有用な文書、文章、または証拠が上位に表示される。 |
| 5. 統合 | システムが回答を作成します。 |
| 6. 出典の添付 | 一部の情報源には、目に見える形で出典が明記されます。 |
その価値は、マーケターがどの部分を形作ることができ、どの部分がモデルに委ねられるかを把握することにあります。
1. クエリの解釈:ユーザーは実際に何を尋ねているのか?
この段階では、システムが意図、文脈、そしてその質問を満たす回答の種類を解析します。
Googleが2019年に発表したBERTに関する発表によると、毎日処理されるクエリの15%はシステムにとって初めてのものであるため、あらゆるプロンプトを予測することは誰にもできません。
例えば、「50人のSaaS営業チームに最適なCRMは何ですか?」というクエリを考えてみましょう。
効果的なSEOのためのオールインワン・プラットフォーム
ビジネスが成功する背景には、強力なSEOキャンペーンがあります。しかし、数え切れないほどの最適化ツールやテクニックがあるため、どこから手をつければいいのかわからないこともあります。でも、もう心配はありません。効果的なSEOのためのオールインワンプラットフォーム「Ranktracker」を紹介します。
キーワードの一致はあくまで出発点に過ぎません。なぜなら、答えは「最適」が何を意味するか、そして50人のSaaS(Software-as-a-Service)チームに何が必要かによって左右されるからです。また、どの製品が顧客関係管理(CRM)ツールとして適しているか、さらにユーザーがコスト、セットアップ、レポート機能、連携機能、あるいは成長のどれを最も重視しているかによっても答えは変わります。
マーケターが影響を与えられること
- 明確なエンティティ表現:企業、製品、またはサービスが何であるかを明確に示す。
- 対象者の定義:そのオファーが誰に向けたものかを明示する。
- 課題との関連付け:製品やサービスが解決する課題と結びつける。
- 条件の明確化:各主張が適用される場合と適用されない場合を明記する。
マーケターがコントロールできないこと
- プロンプトの解釈:システムが1人のユーザーの正確な言葉遣いをどのように読み取るか。
- 会話の文脈:回答を形作る、それ以前のやり取り。
- 意図の重み付け:システムがどの解釈を最も重要と判断するか。
実践的な教訓:あらゆるプロンプトを予測しようとせず、テーマそのものを明確にすることです。
2. サブクエリの展開:1つの質問が複数の検索に発展する
この段階では、1つの広範な質問が、いくつかのより具体的な情報ニーズへと変化します。
複雑な質問には、検索すべき項目が1つだけというケースはめったにありません。Googleはこのクエリの分割を「ファンアウト(fan-out)」と呼んでいます。AI機能に関するドキュメントによると、「AI Overviews」と「AI Mode」は、サブトピックや情報源を横断して複数の関連検索を実行し、回答を構築することができるとされています。
これにより、関連性の捉え方が変わります。なぜなら、ページはプロンプトの正確な文言と一致する必要がないからです。システムが検索過程で確認する関連質問の1つに答えるだけで、検索結果に表示される可能性があります。
例えば
「50人のSaaS営業チームに最適なCRMは何ですか?」といったクエリは、次のような関連する情報ニーズを生み出す可能性があります:
- CRMの価格設定
- チーム規模の適合性
- 営業レポート
- セットアップの工数
- SaaSとの連携
- 拡張性
ほとんどのシステムでは、具体的な展開の全容は非公開ですが、この原則は依然として成り立ちます。
マーケターが影響を与えられること
サイトが主たる質問と、それに付随する主要な質問のすべてに答えられるよう、十分な網羅性を確保することです。
これには以下が含まれます:
- 密接に関連するトピックに関するサポートページ。
- 関連リソース間の強力な内部リンク。
- より広範な記事内でのサブトピックの明確な網羅。
- 個別の意図が存在する場合にのみ作成される、独立したページ。
マーケターが制御できないこと
システムが決定する事項:
- どのファンアウトクエリを作成するか
- 実行すべき検索の回数
- どのサブトピックが最も重要か
- どの読み込みを優先するか
だからこそ、プロンプトのバリエーションごとに1ページずつ、数十ものほぼ同一のページを作成するといった計画は、非効率的です。Google自身のガイドラインでも、このパターンはスパムとして扱われます。
3. 検索:どの情報源が候補セットに含まれるか?
検索とは、システムが質問への回答に役立つ情報源を見つける段階です。検索拡張生成(RAG)は、言語モデルと、その外部から取得された情報を組み合わせたものです。Googleによると、同社のAI機能は、中核となる検索ランキングシステムを利用して、インデックスから関連性が高く最新のページを取得しているとのことです。
マーケターにとって、この段階は馴染み深いはずです。AIによる回答は、システムが見つけ出し、取得できる情報しか利用できないため、これがSEOが依然として重要である理由の1つとなっています。
検索段階において役立つもの
| 影響範囲 | その重要性 |
| クロール可能性 | 検索システムは重要なページにアクセスできる必要があります。 |
| インデックス登録可能性 | ページは、検索可能なインデックスに登録される条件を満たす必要があります。 |
| アクセシブルなコンテンツ | 重要な情報は、不安定なレンダリングやアクセスしにくいインターフェースに依存してはなりません。 |
| 内部リンク | しっかりとしたサイト構造により、重要なページとその関連性が明確に示されます。 |
| トピックとの関連性 | ページには、必要な情報への実質的なリンクが必要です。 |
| 有用なコンテンツ | 条件を満たしているからといって、質の低いページが競争力を持つわけではありません。 |
企業の制御の及ばない部分
マーケターが指示できないこと:
- 特定の1つのURLを取得するかどうか
- 候補セットの規模はどの程度になるか
- 他にどの競合サイトが検索結果に含まれるか
- 1つのクエリから次のクエリへと検索結果がどの程度変化するか
Googleの検索の仕組みに関するガイドには、クロール、インデックス作成、配信という3つの段階が挙げられています。また、Googleは、そのルールに従っているページであっても、これらのいずれについても保証しないとしています。ルールに準拠することでページは対象となる資格を得ますが、それだけです。
検索結果への表示は「ゲート」のようなものであり、コンテンツがそこを通過できなければ、その後の段階での努力ではそれを補うことはできません。
4. パッセージ・ランキング:どの証拠が有用で、保持すべきか?
検索により、情報源が検討対象となります。パッセージ・ランキングは、その情報源に含まれる情報が、保持するに足るほど有用であるかどうかを判断します。検索された文書は、そのすべての単語をそのまま回答に反映するわけではありません。
効果的なSEOのためのオールインワン・プラットフォーム
ビジネスが成功する背景には、強力なSEOキャンペーンがあります。しかし、数え切れないほどの最適化ツールやテクニックがあるため、どこから手をつければいいのかわからないこともあります。でも、もう心配はありません。効果的なSEOのためのオールインワンプラットフォーム「Ranktracker」を紹介します。
システムは、どの事実がタスクに適しているかを選択する必要があります。製品によっては、文書全体、パッセージ、あるいはより小さな証拠単位をランク付けすることができます。
弱い証拠と有用な証拠
ソフトウェアのセットアップ費用に関する質問に答える2つの文章を考えてみましょう。
弱いバージョン:「導入は迅速で、成長中の企業にとって手頃な価格です。」
より有力なバージョン:「導入コストは、移行量、統合要件、ユーザー数、および必要なカスタム設定の量によって異なります。複数のレガシーツールから移行する企業は、通常、単一のプラットフォームから移行するチームよりも多くの導入作業に直面することになります。」
2つ目の文章の方が有用である理由は、以下の点が説明されているからです:
- 結果に影響を与える要因
- それらの要因がどのように関連しているか
- この主張が適用されるのはどこか
- 状況によって答えが変わる理由
マーケターが影響を与えられること
- 具体性:詳細な根拠に基づいた直接的な回答を示す。
- 証拠の近接性:証拠は、それを裏付ける主張のすぐ隣に配置する。
- 限定事項:制限や条件を明記する。
- 各セクションの明瞭さ:周囲の文脈をあまり参照しなくても、各セクションが理解できるようにする。
- 因果関係の表現:何が起こるかだけでなく、なぜ起こるのかを説明する。
マーケターがコントロールできないこと
企業が把握したり指示したりできないこと:
- 非公開の再ランク付けスコア
- 内部閾値
- 重み付けシステム
- 競合する文章
- モデルがコンテキスト空間をどのように活用するか
「答えを先に提示する書き方」がここで有効なのは、明確な文章が、文章の内容を読み解く際に生じる推測の余地をなくすからです。AIシステムに、決まった段落の長さや定型文を要求するものはありません。
5. 統合:モデルが回答を構築する
統合とは、取得した情報を質問にふさわしい回答へと変換する段階です。これは、生成AIについて考える際、多くの人が思い描く段階です。
モデルには次のような能力がある:
- 複数の情報源の統合
- 長い説明を要約する
- 重複する情報を整合させる
- 利用可能な事実のうち一部のみを保持する
- ユーザーのクエリや文脈に合わせて表現を調整する
マーケターが依然として影響力を行使できる領域
次のようなソース素材を公開する:
- 正確
- 具体的
- 裏付けがしっかりしている
- 内容に一貫性がある
- 誤解されにくい
制御が及ばなくなる範囲
モデルが制御するのは:
- 最終的な表現
- 口調
- 回答の長さ
- どの事実を取り上げるか
- 情報源をどのように組み合わせているか
- 何を省略しているか
この境界が重要である:AEOは、検索システムや執筆システムが受け取る素材の質を向上させる一方で、執筆システム自体はモデルに留まる。
6. 引用情報の付加:どの情報源に目に見えるクレジットが与えられるか?
引用は最終的に目に見える成果であり、マーケターが最も重視する段階でもあります。これを検索や利用とは区別して扱う必要があります。
企業が改善できること
- 検証可能な主張
- 出典の明確な出所
- 主張の近くに証拠を提示しているか
- 独自または特徴的な情報
- 初期段階で既に良好なパフォーマンスを示しているページ
企業が決定できないこと
- 引用数がいくつあるか
- どの出典が評価されるか
- 引用がどこに添付されているか
- 競合する情報源が代わりに採用されるかどうか
この境界こそがAEOの中核となる考え方です。選択の条件を改善することはできますが、選択そのものを要求することはできません。
高コストな過ち:誤った段階で最適化を行うこと
AEOにおける最大の無駄は、誤った段階に戦術を適用することに起因します。チームは失敗の原因を特定する前に最適化に飛びついてしまい、その結果、診断を伴わない活動となってしまいます。
例1:ページが検索できない
重要なページがインデックス登録できないと仮定しましょう。そのページの「よくある質問(FAQ)」セクションを「AIによる抽出可能性」を考慮して書き直しても問題は解決しません。なぜなら、失敗はそれより前の段階、つまり発見と取得の段階で発生しているからです。
例2:ページは取得できるが、内容が不十分
次に、逆のケースを考えてみましょう。ページはクロール可能で、インデックスも登録されており、関連する検索で順位もついているものの、その主張が曖昧で裏付けがない場合です。この弱点は証拠の選定段階に近い場所に起因しているため、より技術的なマークアップを施しても解決しません。
最適化する前に診断を行う
| もし問題が… | まずは…に焦点を当ててください。 |
| ページが検索エンジンに発見されない | クロール可能性、インデックス登録可能性、サイトアーキテクチャ |
| ページは取得されるが、役に立たない | 関連性、明瞭さ、根拠 |
| 回答が曖昧、または一般的すぎる | 具体性、第一者情報、およびより強力な裏付け |
| 競合他社が繰り返し引用されている | 証拠の質および情報源の有用性の比較 |
| ブランド名は登場するが、引用されていない | 帰属パターンと情報源レベルの測定 |
これにより、AEOが単なる流行りの技術的タスクの羅列に堕することを防げます。
GoogleのAI検索最適化ガイドもこれを裏付けています。Google検索においては、llms.txtファイルも特別なAIマークアップも必要ありません。また、細分化されたコンテンツやAI専用のSchema.orgマークアップも不要です。同ガイドでは、検索結果を操作するために作成された、ファンアウトクエリごとに個別のページを作成することは、Googleの「スケーラブルなコンテンツの悪用」ポリシーに違反するとされています。
ページ構造は、別の理由から依然として重要です。短い段落、明確な見出し、完結した回答は、ユーザーがコンテンツを理解し、関係性を明確に把握するのに役立ちます。これらを「引用を強制する秘密のコード」としてではなく、優れた文章として扱ってください。
マーケターは実際に何を最適化できるのか?
実用的なAEOの取り組みのほとんどは、発見、証拠の質、測定という3つの領域に分類されます。
6段階モデルは診断に役立ちます。実際には、マーケターは、これら3つの領域に分類される、自らが形作ることができるシステムの部分を改善していきます。
1. 重要な情報を検索対象にする
基本から始めましょう。プラットフォームがウェブ検索やインデックス化されたコーパスに依存している場合は、重要なページはクローラーに公開され、正しく読み込まれ、インデックス登録可能である必要があります。
Googleの場合、AI機能に対しても標準的なSEO対策が依然として適用されます。OpenAIのChatGPT検索に関するヘルプページでは、サイト運営者に対し、OAI-SearchBotクローラーのアクセスを許可して検索対象となるよう求めており、表示順位は保証されないとも記載されています。
これを2つのステップとして考えてください:
- SEOは情報を発見可能にします。有用なページは、まず見つけられなければなりません。
- AEOは、その答えを実用的なものにします。ページが見つかったら、答えを明確にし、証拠を豊富に盛り込み、文脈に容易に当てはめられるようにします。
2. 証拠の質を向上させる
ディスカバリーが機能するようになれば、品質とは単に「より良い記事を書く」こと以上の意味を持ちます。各文章が、システムが責任を持ってそれを活用するのに十分な情報を提供しているかどうかを自問してください。
有用な品質チェックの方法は次の通りです:
- 主張の内容は何か?
- それを裏付ける証拠は何か?
- どのような条件がそれに影響を与えるのか?
- 出典は明確か?
- 推測なしにその文章を理解できますか?
- 既存のコンセンサスを超える新たな知見は含まれているか?
ある手法が「より速い」と主張する場合、何と比べて速いのか、どのような条件下で、そして誰の証拠に基づいているのか?
統計データを引用する場合、その算出方法は公開されていますか?
サービスについて記述する場合、それが誰を対象としており、どのような問題を解決するのかが明確か?
制限事項がある場合、それは主張の直後に記載されているか、それとも3セクションも後に埋もれてしまっているか?
質の高いAEOコンテンツは曖昧さを排除します。また、Googleのガイドラインも同様に「ユーザー第一」の姿勢を貫いており、検索のバリエーションを網羅するために作成された汎用的なページよりも、有用で独創的なコンテンツを優先しています。
3. ジャーニーのあらゆる段階を測定する
引用は可視性を示しますが、なぜ表示されたのか、あるいはなぜ消えたのかを説明するものではありません。
掲載の有無といった単純な結果だけでなく、より詳細なデータを追跡しましょう。
| 追跡すべき項目 | そこから何が明らかになるか |
| プロンプトまたはクエリ | どの情報のニーズが可視化を引き起こしたか |
| プラットフォーム | 引用行動に違いが見られる場所 |
| 引用されたURL | どのページが選択されるか |
| 参照されたセクション | どの箇所が有用に見えるか |
| 競合する情報源 | 同じ情報ニーズに対して、どの情報源が常に選ばれているか |
| オーガニック検索での可視性 | 検索結果と標準的な検索可視性が重複しているか |
| リンクのないブランド言及 | その企業が、出典表示なしに回答を投稿しているかどうか |
そして、そのパターンを比較してください。
そのページはインデックスから外れてしまったのでしょうか?
自然検索結果には表示されるが、自動生成された回答には表示されないか?
独自のデータを持っているため、別のパブリッシャーが繰り返し引用され続けているのでしょうか?
リンクが貼られずに言及されているだけでしょうか?
効果的なSEOのためのオールインワン・プラットフォーム
ビジネスが成功する背景には、強力なSEOキャンペーンがあります。しかし、数え切れないほどの最適化ツールやテクニックがあるため、どこから手をつければいいのかわからないこともあります。でも、もう心配はありません。効果的なSEOのためのオールインワンプラットフォーム「Ranktracker」を紹介します。
こうしたパターンを把握することで、引用漏れをすべて執筆上の問題として扱うよりも、より適切な判断を下すことができます。
引用漏れを診断する簡単な方法
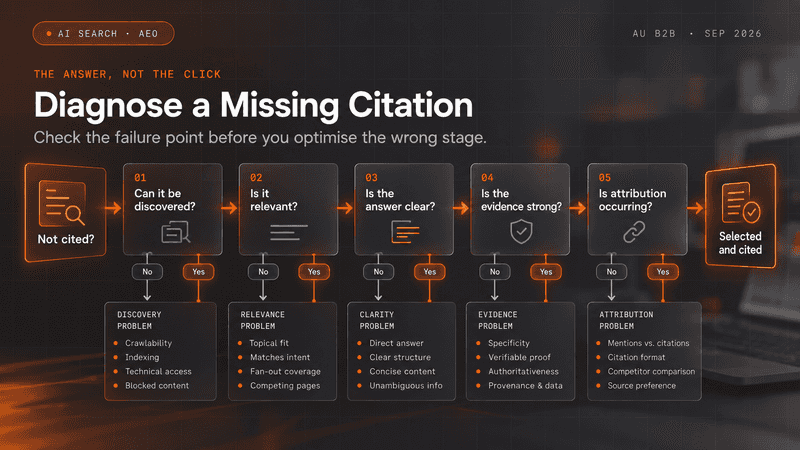
引用が欠落している場合は、文章を書き直す前に、以下の段階を順を追って確認してください。「どうすればAIにこのページを引用させられるか?」という問いを、5つの診断質問に置き換えてみてください。
- そのページは発見可能か?技術的なアクセス状況、クロール可能性、インデックス登録状況を確認する。Googleの技術要件ページには、3つのテストが記載されている:Googlebotがブロックされていないこと、ページがHTTP 200ステータスを返すこと、そしてページにインデックス登録可能なコンテンツが含まれていること。
- 必要な情報に関連していますか?正確なキーワードだけでなく、関連する質問やそこから派生しうる話題にも目を向けてください。
- そのページには明確な答えが載っていますか?その質問に答えるはずの箇所を見つけましょう。人間が見つけるのに苦労するほど曖昧な場合は、説明が不十分です。
- 証拠は十分に説得力がありますか?そのページを、すでに掲載されている情報源と比較してください。一次データ、より説得力のある説明、より明確な条件、あるいはより信頼性の高い出典を探してください。
- 出典の明記に問題はありませんか?回答にブランド名やその事実が記載されているにもかかわらず、そのページへの明確な引用がない場合、問題は情報チェーンのより下流に存在します。
この順序に従うことで、初期段階の問題がページの公開を妨げているにもかかわらず、チームが後期段階の対策に予算を費やすことを防げます。
引用されるための条件を最適化する
コンテンツが検索、証拠の選定、出典の明示において有力な候補となるよう、その条件を最適化します。
とはいえ、保証されるものはありません。『Google Search Essentials』によれば、すべての要件とベストプラクティスを満たしているページであっても、クロール、インデックス登録、または表示される保証はないとされています。OpenAIも、ChatGPTでの検索順位について同様の見解を示しています。これは「AI検索結果を席巻する」という約束ほど刺激的ではありませんが、マーケターにとってははるかに実用的なアプローチとなります。
マーケターにできること:
- 重要なコンテンツを見つけやすくする
- 具体的で裏付け可能な回答を公開する
- 実際の顧客の質問に基づいてトピックの網羅性を高める
- 再利用された要約ではなく、独自のエビデンスを作成する
- 商業的に重要な質問に継続的に回答している情報源を追跡する
- 一度にすべてを変更するのではなく、脆弱な段階を特定する
できないのは、プライベートモデルによるクエリの解釈、内部スコアリング、あるいは最終的な引用先の選択を制御することです。

