Inleiding
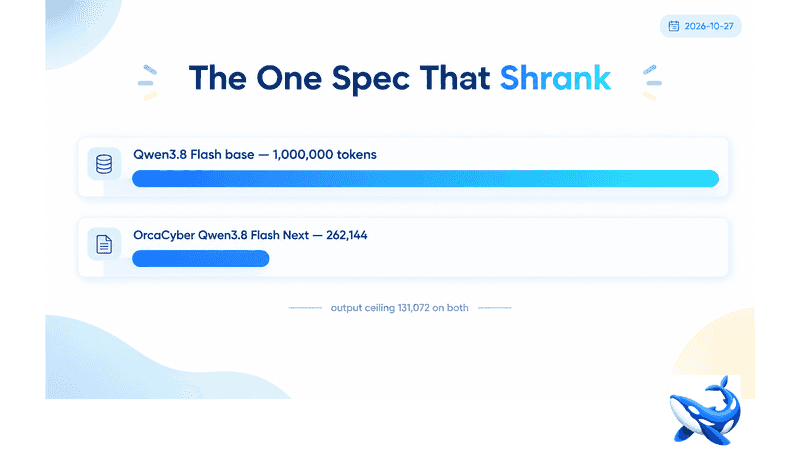
Via OrcaRouter staan het basismodel en de getunede versie naast elkaar op één toets, en de vergelijking is ongewoon duidelijk. De Qwen3.8 Flash Next-kaart — OrcaCyber’s sterk vereenvoudigde versie van Alibaba’s Qwen3.8 Flash Next, uitgebracht op 26-10-2026 — bevat 262.144 contexttokens, tegenover de 1.000.000 [OURS] van het basismodel. Dat is 26,2%, net iets meer dan een kwart. Al het andere aan de specificaties blijft behouden: het outputplafond is bij beide 131.072, de modaliteiten zijn bij beide tekst, afbeelding en video.
De context is de specificatie die is verkleind, en juist die bepaalt wat een workflow kan doen.
De cijfers, naast elkaar
| Qwen3.8 Flash (basis) | OrcaCyber Qwen3.8 Flash Volgende | |
| Contextvenster | 1.000.000 | 262.144 |
| Maximale uitvoer | 131.072 | 131.072 |
| Invoermodaliteiten | tekst, afbeelding, video | tekst, afbeelding, video |
| Invoer / M | $0,15 | $0,80 |
| Uitvoer / M | $0,47 | $1,60 |
| Cache-lezen / M | $0,0184 | $0,15 |
| Cache schrijven / M | $0,23 | — |
| Vrijgegeven | 26-08-2026 | 26-10-2026 |
Drie dingen vallen op. Het outputplafond is niet veranderd, wat betekent dat een lang artefact nog steeds in één antwoord past. De modaliteiten zijn niet veranderd, wat betekent dat het visuele pad de afstemming heeft overleefd. En de inputprijs is met een factor 5,33 vermenigvuldigd, terwijl het venster met een factor 3,8 is gekrompen — je betaalt meer per token voor minder ruimte.
Wat 262.144 tokens eigenlijk bevat
Een kwart miljoen tokens is niet weinig. Dat zijn ruwweg 200.000 woorden, of een boek van 400 pagina’s, of de broncode van een middelgrote repository inclusief de bijbehorende manifesten.
Wat er niet in past, is de volledige inhoud van een grote monorepo plus de bijbehorende logs en de ticketgeschiedenis. Juist bij die combinatie komt een venster van een miljoen tokens tot zijn recht, en dat is precies de combinatie die deze kaart niet aankan.
Het praktische gevolg is een ontwerpbeslissing die je moet nemen voordat je gaat bouwen: één aanroep of twee. Bij het basismodel is een grote audit één verzoek. Op deze kaart wordt hetzelfde materiaal verdeeld over twee verzoeken — gesplitst op een natuurlijke grens, waarbij de bevindingen van de eerste helft als context worden meegenomen naar de tweede aanroep.
Het opsplitsen is niet gratis. Je betaalt tweemaal de outputtarief voor elke synthesestap, je verliest grensoverschrijdende redeneringen en je creëert ruimte waar fouten zich kunnen opstapelen. Voor een repository waar de kwetsbaarheid in één pakket zit, maakt dat allemaal niets uit. Voor een repository waar de bug een mismatch is tussen service A en service C, maakt het wel uit.
Waarom een kwartvenster toch de juiste keuze kan zijn
Er is een verdedigbare reden waarom de build wordt uitgebracht op 262.144 in plaats van een miljoen, en dat is geen luiheid: het verwerken van een lange context is duur. Aandacht voor meer dan een miljoen tokens kost bij elk verzoek geheugen en tijd, en een ‘abliterated’ build draagt al een afstemmingsverschil bovenop de basisgewichten. Door het venster tot een kwart te verkleinen, blijft de kaart bruikbaar bij een input van $0,80 in plaats van tegen een tarief waarbij de ‘refusal-free’-premie klein zou lijken.
Het alles-in-één platform voor effectieve SEO
Achter elk succesvol bedrijf staat een sterke SEO-campagne. Maar met talloze optimalisatietools en -technieken om uit te kiezen, kan het moeilijk zijn om te weten waar te beginnen. Nou, vrees niet meer, want ik heb precies het ding om te helpen. Ik presenteer het Ranktracker alles-in-één platform voor effectieve SEO
We hebben eindelijk de registratie voor Ranktracker helemaal gratis geopend!
Maak een gratis account aanOf log in met uw gegevens
Of die afweging voor jou geschikt is, hangt af van de verdeling van je inputs. Als de meeste van je verzoeken minder dan 100.000 tokens bevatten — een enkel bestand, een stacktrace, een screenshot plus een document — raakt het venster nooit aan de limiet en is de kaart gewoon een goedkoper te verwerken ‘abliterated’-model. Als je verzoeken regelmatig meer dan 200.000 bedragen, is het basismodel of een variant met een venster van 1 miljoen de juiste keuze en is het prijsverschil van ondergeschikt belang.
Wat de gate vraagt, en waarom het een week duurt
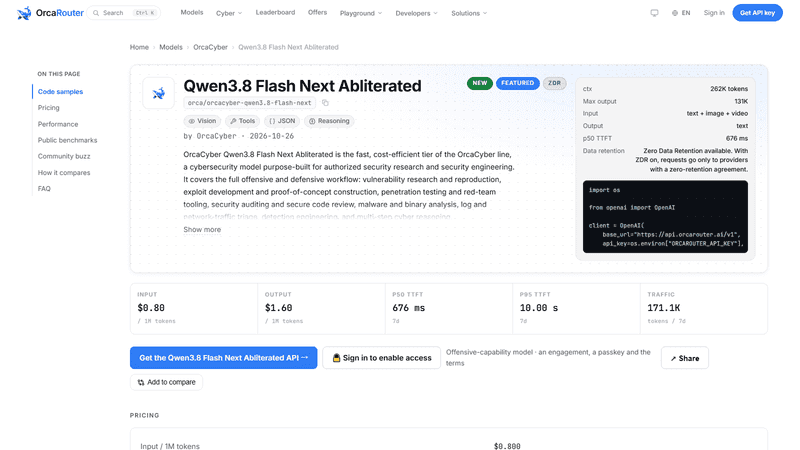
Toegang tot elke OrcaCyber-kaart verloopt via een aanvraagprocedure, een toegangscode en het accepteren van de voorwaarden voordat het eindpunt een verzoek verwerkt [ONZE]. Bij een kaart die je aan het evalueren bent in plaats van te verzenden, is die volgorde gemakkelijk uit te stellen — en het uitstellen ervan is de meest voorkomende reden waarom een overstap mislukt.
Behandel het als de eerste taak in plaats van de laatste. Het papierwerk verloopt parallel aan de technische evaluatie, en de twee beantwoorden verschillende vragen: of je de kaart wilt, en of je hem kunt krijgen.
Eén gevolg is het waard om rekening mee te houden. Een toegangscode is een operationeel geheim dat in je implementatieconfiguratie terechtkomt, wat betekent dat het het proces voor het rouleren van geheimen doorloopt dat je hanteert. Als dat proces twee weken duurt, is dat de werkelijke doorlooptijd, niet het model.
Wat een kwartaalvenster verandert aan het testen
Als je deze kaart vergelijkt met het basismodel, verandert het venster zowel het testontwerp als de werklast.
Een testcase die 400.000 tokens verstuurt, kan helemaal niet op deze kaart worden uitgevoerd, dus de vergelijkingsset moet worden samengesteld uit materiaal dat voor beide geschikt is. Dat is prima — het is dezelfde set die je in productie zou gebruiken — maar het betekent dat de evaluatie je niet kan vertellen hoe de kaart omgaat met de inputs die hij niet kan accepteren.
Voor die verzoeken is de enige zinvolle vraag die over de routering: welk deel van het verkeer komt daar terecht, en wat gebeurt ermee? Er moet een routeringsregel bestaan die te grote verzoeken naar het basismodel stuurt vóór het eerste verzoek mislukt, niet erna.
Wat de pagina je nog niet vertelt
De kaart is op het moment van schrijven één dag oud, en de telemetrie laat dat zien: er zijn 1.345 tokens doorheen gegaan in de gemeten week [ONZE]. Dat zijn maar een handvol verzoeken. Het latentieblok op de pagina rapporteert een p50 van 500 ms en een foutenpercentage van 75% — beide berekend op basis van datzelfde handvol, en geen van beide is een uitspraak over het model.
Het alles-in-één platform voor effectieve SEO
Achter elk succesvol bedrijf staat een sterke SEO-campagne. Maar met talloze optimalisatietools en -technieken om uit te kiezen, kan het moeilijk zijn om te weten waar te beginnen. Nou, vrees niet meer, want ik heb precies het ding om te helpen. Ik presenteer het Ranktracker alles-in-één platform voor effectieve SEO
We hebben eindelijk de registratie voor Ranktracker helemaal gratis geopend!
Maak een gratis account aanOf log in met uw gegevens
Dit is dus een kaart die je moet beoordelen op basis van de specificaties en je eigen tests, niet op basis van praktijkgegevens. De specificaties zijn duidelijk genoeg: een kwartvenster, een volledige outputlimiet, drie invoermodaliteiten, een invoervermenigvuldigingsfactor van 5,33× en een afstemming die afwijzingen voorkomt.
Het alles-in-één platform voor effectieve SEO
Achter elk succesvol bedrijf staat een sterke SEO-campagne. Maar met talloze optimalisatietools en -technieken om uit te kiezen, kan het moeilijk zijn om te weten waar te beginnen. Nou, vrees niet meer, want ik heb precies het ding om te helpen. Ik presenteer het Ranktracker alles-in-één platform voor effectieve SEO
We hebben eindelijk de registratie voor Ranktracker helemaal gratis geopend!
Maak een gratis account aanOf log in met uw gegevens
De test die uitsluitsel geeft, kost een middag. Neem tien verzoeken die je al naar het basismodel stuurt, speel ze opnieuw af op deze kaart en noteer twee dingen: of er bij een van deze verzoeken meer dan 262.144 tokens nodig waren, en of een van deze verzoeken door het basismodel werd geweigerd. Als het eerste antwoord ‘nee’ is en het tweede ‘vaak’, dan is de kaart geschikt. Als het eerste antwoord ‘ja’ is, kan geen enkele afstemming dit compenseren.
De conclusie
De uitgeklede Qwen3.8 Flash Next behoudt het outputplafond en de modaliteiten, vermenigvuldigt de prijs met 5,33× aan de inputzijde en geeft driekwart van het contextvenster terug. Dat laatste cijfer is doorslaggevend.
Als je invoer binnen 262.144 tokens past, doet de kaart wat hij belooft. Als dat niet het geval is, is het basismodel met een invoersnelheid van een vijfde de betere keuze, en geen enkele afstemming verandert die rekensom.
Bronvermelding: prijzen, contextvensters, limieten en modaliteiten zijn afkomstig uit de OrcaRouter-catalogus, gecontroleerd op 27-10-2026 [ONS]. Het wekelijkse volume van 1.345 tokens is afkomstig uit de productietelemetrie van OrcaRouter voor de zeven dagen eindigend op 26-10-2026, en is te klein om enige bewering over latentie of betrouwbaarheid te onderbouwen — hier worden dan ook geen beweringen gedaan [OURS]. Benchmarkrijen worden in dit artikel niet gebruikt.

