Wprowadzenie
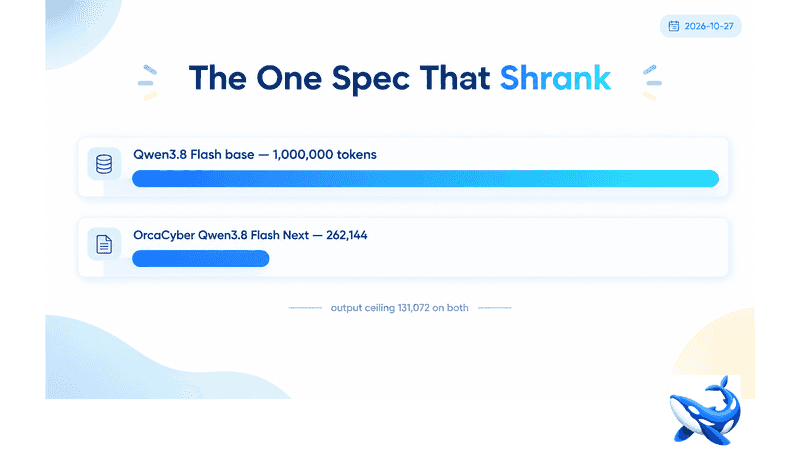
Dzięki OrcaRouter model podstawowy i zoptymalizowana wersja znajdują się obok siebie na jednym klawiszu, a porównanie jest niezwykle dosadne. Karta Qwen3.8 Flash Next — zoptymalizowana wersja modelu Qwen3.8 Flash Next firmy Alibaba, opracowana przez OrcaCyber i wydana 26 października 2026 r. — zawiera 262 144 tokenów kontekstu, w porównaniu z 1 000 000 [OURS] w modelu podstawowym. Stanowi to 26,2%, czyli nieco ponad jedną czwartą. Wszystkie pozostałe parametry pozostały niezmienione: maksymalna liczba wyników wynosi 131 072 w obu przypadkach, a obszary zastosowań to tekst, obraz i wideo w obu modelach.
To właśnie specyfikacja dotycząca kontekstu uległa zmniejszeniu i to właśnie ona zmienia możliwości danego przepływu pracy.
Liczby obok siebie
| Qwen3.8 Flash (podstawa) | OrcaCyber Qwen3.8 Flash Next | |
| Okno kontekstowe | 1 000 000 | 262 144 |
| Górna granica wydajności | 131 072 | 131 072 |
| Formy danych wejściowych | tekst, obraz, wideo | tekst, obraz, wideo |
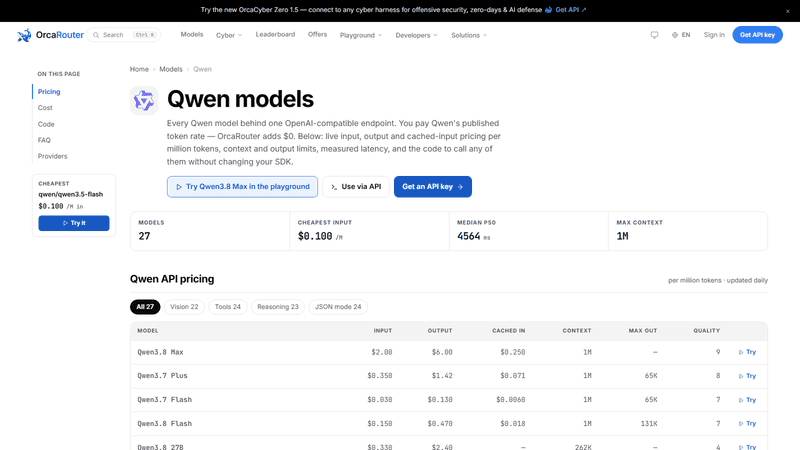
| Dane wejściowe / M | 0,15 USD | 0,80 |
| Wynik / M | 0,47 | 1,60 |
| Odczyt z pamięci podręcznej / M | 0,0184 | 0,15 |
| Zapis z pamięci podręcznej / M | 0,23 | — |
| Opublikowano | 26 sierpnia 2026 r. | 26.10.2026 |
Wyróżniają się trzy kwestie. Górna granica wyjściowa pozostała bez zmian, co oznacza, że długi artefakt nadal mieści się w jednej odpowiedzi. Modalności pozostały bez zmian, co oznacza, że ścieżka wizualna przetrwała dostosowanie. Natomiast cena danych wejściowych wzrosła 5,33-krotnie, podczas gdy okno zmniejszyło się 3,8-krotnie — płacisz więcej za token, mając mniej miejsca.
Co faktycznie mieści się w 262 144 tokenach
Ćwierć miliona tokenów to nie mało. To około 200 000 słów, czyli książka licząca 400 stron, albo kod źródłowy średniej wielkości repozytorium wraz z dołączonymi manifestami.
Nie mieści się w nim jednak całość dużego monorepozytorium wraz z logami i historią zgłoszeń. To właśnie w tej kombinacji okno o milionie tokenów uzasadnia swoją cenę i jest to dokładnie ta kombinacja, której ta karta nie jest w stanie obsłużyć.
Praktyczną konsekwencją jest decyzja projektowa, którą musisz podjąć przed rozpoczęciem pracy: jedno wywołanie czy dwa. W modelu podstawowym duży audyt to jedno żądanie. W przypadku tej karty ten sam materiał wymaga dwóch wywołań — podzielonych w naturalnym miejscu, przy czym wyniki pierwszej połowy są przenoszone do drugiego wywołania jako kontekst.
Podział nie jest bezkosztowy. Za każdy etap syntezy płacisz dwukrotnie stawkę za dane wyjściowe, tracisz możliwość wnioskowania międzygranicznego i zyskujesz miejsce, w którym błędy mogą się kumulować. W przypadku repozytorium, w którym luka występuje w jednym pakiecie, nic z tego nie ma znaczenia. W przypadku repozytorium, w którym błąd polega na niezgodności między usługą A a usługą C, ma to znaczenie.
Dlaczego okno o wielkości jednej czwartej może nadal być właściwe
Istnieje uzasadniony powód, dla którego kompilacja jest dostarczana przy wartości 262 144 zamiast miliona, i nie jest to lenistwo: obsługa długiego kontekstu jest kosztowna. Obsługa ponad miliona tokenów kosztuje pamięć i czas przy każdym żądaniu, a kompilacja z ablacją już zawiera korektę optymalizacyjną nałożoną na podstawowe wagi. Ograniczenie okna do jednej czwartej pozwala utrzymać obsługę karty przy kosztach wejściowych 0,80 USD, zamiast przy stawce, która sprawiłaby, że premia za brak odmowy wydawałaby się niewielka.
Platforma "wszystko w jednym" dla skutecznego SEO
Za każdym udanym biznesem stoi silna kampania SEO. Ale z niezliczonych narzędzi optymalizacji i technik tam do wyboru, może być trudno wiedzieć, gdzie zacząć. Cóż, nie obawiaj się więcej, ponieważ mam właśnie coś, co może pomóc. Przedstawiamy Ranktracker - platformę all-in-one dla skutecznego SEO.
W końcu otworzyliśmy rejestrację do Ranktrackera całkowicie za darmo!
Załóż darmowe kontoLub Zaloguj się używając swoich danych uwierzytelniających
To, czy ten kompromis Ci odpowiada, zależy od rozkładu Twoich danych wejściowych. Jeśli większość Twoich żądań mieści się poniżej 100 000 tokenów — pojedynczy plik, ślad stosu, zrzut ekranu wraz z dokumentem — okno nigdy nie powoduje ograniczeń, a karta jest po prostu tańszym w obsłudze modelem z abliteracją. Jeśli Twoje żądania rutynowo przekraczają 200 000, właściwym wyborem jest model podstawowy lub jego odpowiednik z oknem 1 mln, a różnica w cenie ma znaczenie czysto teoretyczne.
Czego wymaga brama i dlaczego trwa to tydzień
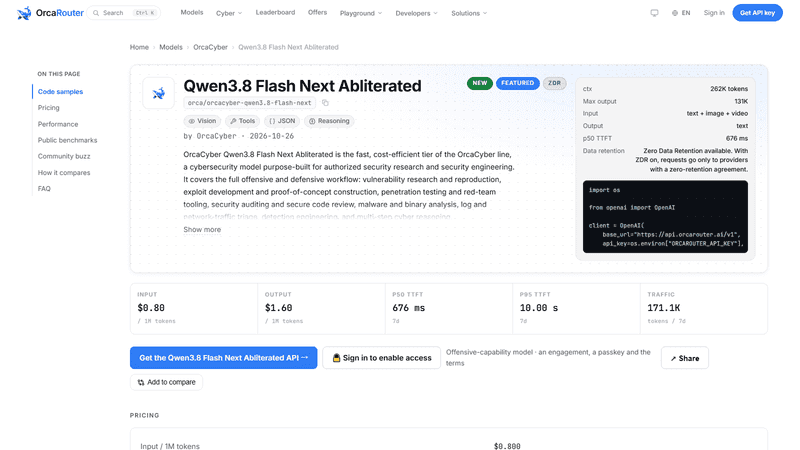
Dostęp do każdej karty OrcaCyber wymaga zawarcia umowy, podania hasła dostępu oraz akceptacji warunków, zanim punkt końcowy obsłuży żądanie [OURS]. W przypadku karty, którą oceniasz, a nie dostarczasz, tę sekwencję łatwo jest odłożyć na później — a właśnie to odkładanie jest najczęstszą przyczyną opóźnień w zmianie dostawcy.
Potraktuj to jako pierwsze zadanie, a nie ostatnie. Formalności przebiegają równolegle z oceną techniczną, a obie te czynności odpowiadają na różne pytania: czy chcesz tę kartę i czy możesz ją otrzymać.
Warto zaplanować jedną z konsekwencji. Klucz dostępu jest sekretem operacyjnym, który trafia do konfiguracji wdrożeniowej, co oznacza, że podlega procesowi rotacji sekretów, jaki stosujesz. Jeśli proces ten trwa dwa tygodnie, to właśnie jest rzeczywisty czas realizacji, a nie ten z modelu.
Jak okno kwartalne zmienia testowanie
Jeśli porównujesz tę kartę z modelem bazowym, to „okno” zmienia zarówno projekt testów, jak i obciążenie.
Przypadek testowy wysyłający 400 000 tokenów nie może być w ogóle uruchomiony na tej karcie, więc zestaw porównawczy musi pochodzić z materiału, który pasuje do obu. To w porządku — jest to ten sam zestaw, którego używałbyś w środowisku produkcyjnym — ale oznacza to, że ocena nie powie ci, jak karta radzi sobie z danymi wejściowymi, których nie może zaakceptować.
W takich przypadkach jedynym przydatnym pytaniem jest kwestia routingu: jaka część ruchu trafia do tej karty i co się z nią dzieje. Reguła routingu, która przekierowuje zbyt duże żądania do modelu podstawowego, musi istnieć przed niepowodzeniem pierwszego żądania, a nie po nim.
Czego strona jeszcze nie ujawnia
W momencie pisania tego tekstu karta działa od jednego dnia, co widać w jej danych telemetrycznych: w mierzonym tygodniu [NASZYM] przeszło przez nią 1 345 tokenów. To zaledwie garść żądań. Blok opóźnień na stronie podaje p50 na poziomie 500 ms i wskaźnik błędów wynoszący 75% — oba obliczone na podstawie tej samej garści żądań i żadna z tych wartości nie stanowi oceny samego modelu.
Platforma "wszystko w jednym" dla skutecznego SEO
Za każdym udanym biznesem stoi silna kampania SEO. Ale z niezliczonych narzędzi optymalizacji i technik tam do wyboru, może być trudno wiedzieć, gdzie zacząć. Cóż, nie obawiaj się więcej, ponieważ mam właśnie coś, co może pomóc. Przedstawiamy Ranktracker - platformę all-in-one dla skutecznego SEO.
W końcu otworzyliśmy rejestrację do Ranktrackera całkowicie za darmo!
Załóż darmowe kontoLub Zaloguj się używając swoich danych uwierzytelniających
Jest to więc karta, którą należy oceniać na podstawie specyfikacji i własnych testów, a nie na podstawie danych z produkcji. Specyfikacja jest wystarczająco jasna: okno ćwierć, pełny pułap wyjściowy, trzy tryby wejściowe, mnożnik wejściowy 5,33× oraz dostrojenie eliminujące odrzucenia.
Platforma "wszystko w jednym" dla skutecznego SEO
Za każdym udanym biznesem stoi silna kampania SEO. Ale z niezliczonych narzędzi optymalizacji i technik tam do wyboru, może być trudno wiedzieć, gdzie zacząć. Cóż, nie obawiaj się więcej, ponieważ mam właśnie coś, co może pomóc. Przedstawiamy Ranktracker - platformę all-in-one dla skutecznego SEO.
W końcu otworzyliśmy rejestrację do Ranktrackera całkowicie za darmo!
Załóż darmowe kontoLub Zaloguj się używając swoich danych uwierzytelniających
Test, który rozstrzyga sprawę, zajmuje jedno popołudnie. Wybierz dziesięć zapytań, które już wysyłasz do modelu bazowego, odtworz je na tej karcie i zanotuj dwie rzeczy: czy któreś z nich wymagało więcej niż 262 144 tokenów oraz czy któreś z nich zostało odrzucone przez model bazowy. Jeśli odpowiedź na pierwsze pytanie brzmi „nie”, a na drugie „często”, karta się sprawdza. Jeśli odpowiedź na pierwsze pytanie brzmi „tak”, żadne dostrojenie tego nie zrekompensuje.
Wniosek
Zredukowany model Qwen3.8 Flash Next zachowuje górny limit wyników i modalności, zwiększa ilość danych wejściowych 5,33-krotnie i zwraca trzy czwarte okna kontekstowego. Ta ostatnia liczba decyduje o wszystkim.
Jeśli twoje dane wejściowe mieszczą się w 262 144 tokenach, karta działa zgodnie z opisem. Jeśli nie, lepszym wyborem jest model bazowy o szybkości przetwarzania wynoszącej jedną piątą szybkości danych wejściowych, a żadne dostrojenie nie zmieni tej arytmetyki.
Uwaga dotycząca źródeł: ceny, okna kontekstowe, limity i modalności pochodzą z katalogu OrcaRouter, sprawdzone 27.10.2026 r. [NASZE]. Tygodniowy wolumen wynoszący 1 345 tokenów pochodzi z telemetrii produkcyjnej OrcaRouter za siedem dni kończących się 26 października 2026 r. i jest zbyt mały, aby uzasadniać jakiekolwiek twierdzenia dotyczące opóźnień lub niezawodności — w niniejszym artykule nie przedstawiono żadnych takich twierdzeń [OURS]. W niniejszym artykule nie wykorzystano wierszy z testów porównawczych.

