Introdução
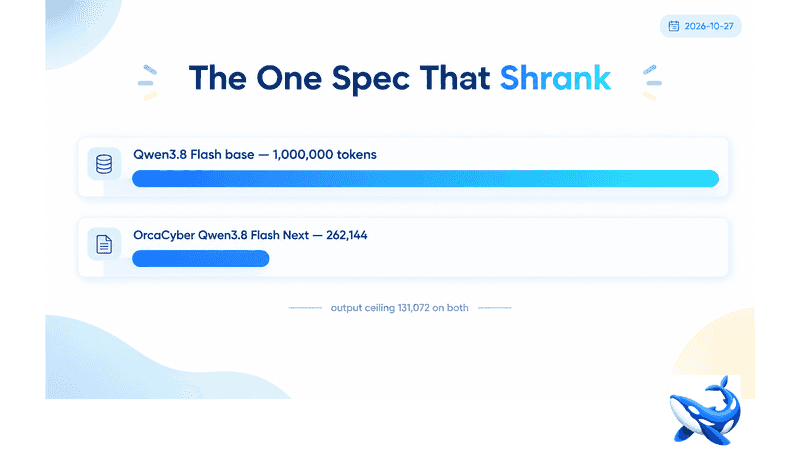
No OrcaRouter, o modelo básico e a versão otimizada aparecem lado a lado em uma única chave, e a comparação é excepcionalmente direta. A placa Qwen3.8 Flash Next — a versão otimizada da OrcaCyber baseada no Qwen3.8 Flash Next da Alibaba, lançada em 26/10/2026 — possui 262.144 tokens de contexto, contra os 1.000.000 [OURS] do modelo básico. Isso representa 26,2%, um pouco mais de um quarto. Todos os outros aspectos do envelope permanecem inalterados: o limite máximo de saída é de 131.072 em ambos, e as modalidades são texto, imagem e vídeo em ambos.
O contexto é a especificação que foi reduzida, e é ele que determina o que um fluxo de trabalho pode fazer.
Os números, lado a lado
| Qwen3.8 Flash (base) | OrcaCyber Qwen3.8 Flash Próximo | |
| Janela de contexto | 1.000.000 | 262.144 |
| Limite máximo de saída | 131.072 | 131.072 |
| Modalidades de entrada | texto, imagem, vídeo | texto, imagem, vídeo |
| Entrada / M | $0,15 | US$ 0,80 |
| Saída / M | $0,47 | $1,60 |
| Leitura de cache / M | $0,0184 | $0,15 |
| Gravação no cache / M | $0,23 | — |
| Lançado | 26/08/2026 | 26/10/2026 |
Três coisas se destacam. O limite máximo de saída não mudou, o que significa que um artefato longo ainda cabe em uma única resposta. As modalidades não mudaram, o que significa que o caminho de visão sobreviveu ao ajuste. E o preço de entrada multiplicou-se por 5,33×, enquanto a janela diminuiu por um fator de 3,8 — você paga mais por token por menos espaço.
O que 262.144 tokens realmente comportam
Um quarto de milhão de tokens não é pouca coisa. São aproximadamente 200.000 palavras, ou um livro de 400 páginas, ou o equivalente a um repositório de tamanho médio com os manifestos anexados.
O que ela não comporta é a totalidade de um grande monorepo, somada aos seus logs e ao histórico de tickets. É nessa combinação que uma janela de um milhão de tokens justifica seu preço, e é precisamente essa combinação que este cartão não consegue suportar.
A consequência prática é uma decisão de projeto que você precisa tomar antes de construir: uma chamada ou duas. No modelo básico, uma grande auditoria corresponde a uma solicitação. Nesta placa, o mesmo material se divide em duas — separadas por um limite natural, com as descobertas da primeira metade levadas para a segunda chamada como contexto.
A divisão tem seu custo. Você paga a taxa de saída duas vezes por qualquer etapa de síntese, perde o raciocínio entre limites e cria um espaço para que os erros se acumulem. Para um repositório em que a vulnerabilidade está em um único pacote, nada disso importa. Para um em que o bug é uma incompatibilidade entre o serviço A e o serviço C, isso importa.
Por que uma janela de um quarto ainda pode estar correta
Há uma razão defensável para a compilação ser lançada com 262.144 em vez de um milhão, e não se trata de preguiça: um contexto longo é caro de ser processado. A análise de mais de um milhão de tokens consome memória e tempo em cada solicitação, e uma compilação simplificada já carrega um delta de ajuste além dos pesos básicos. Reduzir a janela para um quarto mantém o cartão viável com uma entrada de US$ 0,80, em vez de uma taxa que faria o prêmio sem recusas parecer pequeno.
A plataforma All-in-One para uma SEO eficaz
Por trás de cada negócio de sucesso está uma forte campanha de SEO. Mas com inúmeras ferramentas e técnicas de otimização por aí para escolher, pode ser difícil saber por onde começar. Bem, não tenha mais medo, porque eu tenho exatamente o que ajudar. Apresentando a plataforma multifuncional Ranktracker para uma SEO eficaz
Finalmente abrimos o registro para o Ranktracker absolutamente grátis!
Criar uma conta gratuitaOu faça login usando suas credenciais
Se essa troca é adequada para você depende da distribuição de suas entradas. Se a maioria de suas solicitações estiver abaixo de 100.000 tokens — um único arquivo, um rastreamento de pilha, uma captura de tela mais um documento —, a janela nunca se torna restritiva e o cartão é simplesmente um modelo com ablição mais barato de servir. Se suas solicitações costumam ultrapassar 200.000, o modelo básico ou uma variante com janela de 1 milhão é a escolha correta, e a diferença de preço é irrelevante.
O que o gateway exige e por que leva uma semana
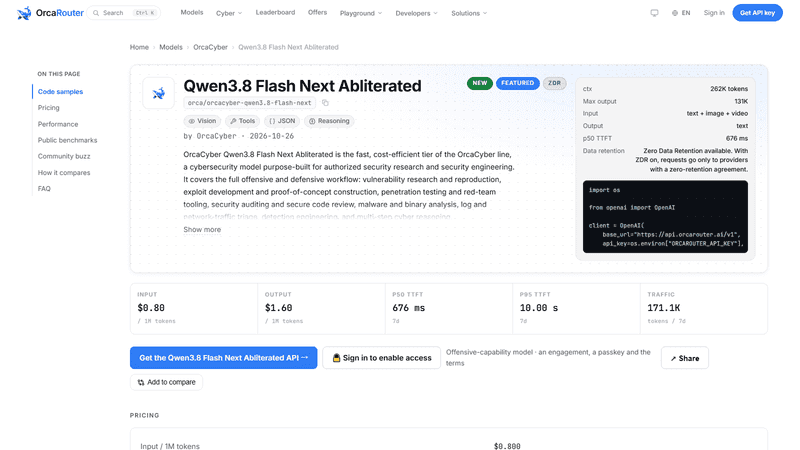
O acesso a todos os cartões OrcaCyber passa por um processo de adesão, uma senha de acesso e a aceitação dos termos antes que o endpoint atenda a uma solicitação [NOSSA]. No caso de um cartão que você está avaliando, em vez de enviar, essa sequência é fácil de adiar — e adiá-la é o motivo mais comum para que a mudança não ocorra.
Trate isso como a primeira tarefa, e não como a última. A parte burocrática ocorre paralelamente à avaliação técnica, e as duas respondem a perguntas diferentes: se você quer a placa e se pode obtê-la.
Vale a pena se planejar para uma consequência específica. Uma senha de acesso é um segredo operacional que acaba fazendo parte da sua configuração de implantação, o que significa que ela passa por qualquer processo de rotação de segredos que você tenha. Se esse processo levar duas semanas, esse é o prazo real, não o modelo.
O que uma janela de um trimestre muda nos testes
Se você estiver comparando esse cartão com o modelo básico, a janela altera tanto o projeto do teste quanto a carga de trabalho.
Um caso de teste que envia 400.000 tokens não pode ser executado nessa placa de forma alguma; portanto, o conjunto de comparação precisa ser extraído de material que se adapte a ambas. Isso é aceitável — é o mesmo conjunto que você usaria em produção —, mas significa que a avaliação não pode indicar como a placa lida com as entradas que não consegue aceitar.
Para esses casos, a única questão útil é a do roteamento: qual parcela do tráfego chega até lá e o que acontece com ela. Uma regra de roteamento que encaminhe solicitações acima do limite para o modelo básico precisa existir antes que a primeira solicitação falhe, não depois.
O que a página ainda não revela
A placa tem um dia de uso no momento da redação deste artigo, e sua telemetria mostra isso: 1.345 tokens passaram por ela na semana medida [A NOSSA]. Isso representa apenas um punhado de solicitações. O bloco de latência na página relata um p50 de 500 ms e uma taxa de erro de 75% — ambos calculados com base nesse mesmo punhado, e nenhum deles é uma afirmação sobre o modelo.
A plataforma All-in-One para uma SEO eficaz
Por trás de cada negócio de sucesso está uma forte campanha de SEO. Mas com inúmeras ferramentas e técnicas de otimização por aí para escolher, pode ser difícil saber por onde começar. Bem, não tenha mais medo, porque eu tenho exatamente o que ajudar. Apresentando a plataforma multifuncional Ranktracker para uma SEO eficaz
Finalmente abrimos o registro para o Ranktracker absolutamente grátis!
Criar uma conta gratuitaOu faça login usando suas credenciais
Portanto, este é um cartão que você deve avaliar com base nas especificações e em seus próprios testes, e não em evidências de produção. A especificação é clara o suficiente: janela de um quarto, limite máximo de saída total, três modalidades de entrada, um múltiplo de entrada de 5,33× e um ajuste que elimina recusas.
A plataforma All-in-One para uma SEO eficaz
Por trás de cada negócio de sucesso está uma forte campanha de SEO. Mas com inúmeras ferramentas e técnicas de otimização por aí para escolher, pode ser difícil saber por onde começar. Bem, não tenha mais medo, porque eu tenho exatamente o que ajudar. Apresentando a plataforma multifuncional Ranktracker para uma SEO eficaz
Finalmente abrimos o registro para o Ranktracker absolutamente grátis!
Criar uma conta gratuitaOu faça login usando suas credenciais
O teste decisivo leva uma tarde. Pegue dez solicitações que você já envia ao modelo base, reproduza-as nessa placa e registre duas coisas: se alguma delas precisou de mais de 262.144 tokens e se alguma delas foi recusada pelo modelo base. Se a primeira resposta for “não” e a segunda for “frequentemente”, a placa é adequada. Se a primeira resposta for “sim”, nenhum ajuste será suficiente para compensar.
A conclusão
O Qwen3.8 Flash Next simplificado mantém o limite máximo de saída e as modalidades, multiplica o preço por 5,33 vezes na entrada e devolve três quartos da janela de contexto. Esse último número é o que determina toda a decisão.
Se suas entradas couberem em 262.144 tokens, a placa faz o que promete. Caso contrário, o modelo base com um quinto da taxa de entrada é a melhor opção, e nenhum ajuste altera essa equação.
Nota de fonte: preços, janelas de contexto, limites máximos e modalidades são do catálogo do OrcaRouter, verificado em 27/10/2026 [NOSSO]. O volume semanal de 1.345 tokens é a telemetria de produção do OrcaRouter para os sete dias encerrados em 26/10/2026, e é pequeno demais para sustentar qualquer afirmação sobre latência ou confiabilidade — nenhuma é feita aqui [NOSSO]. Linhas de benchmark não são utilizadas neste artigo.

